작업 도구가 바뀌어도 이어지는 하나의 Python 평가 엔진
평가를 진행하는 화면과 실제 자료를 처리하는 엔진은 구분됩니다. OpenCode에서 시작한 작업을 Codex가 이어받았으며, 공통 Python 하네스가 접수자료·판독문·모델 응답·집계 결과를 실행 단위로 관리합니다. ‘하네스’는 이 여러 단계를 정해진 절차로 연결하고 기록하는 처리 체계를 뜻합니다.
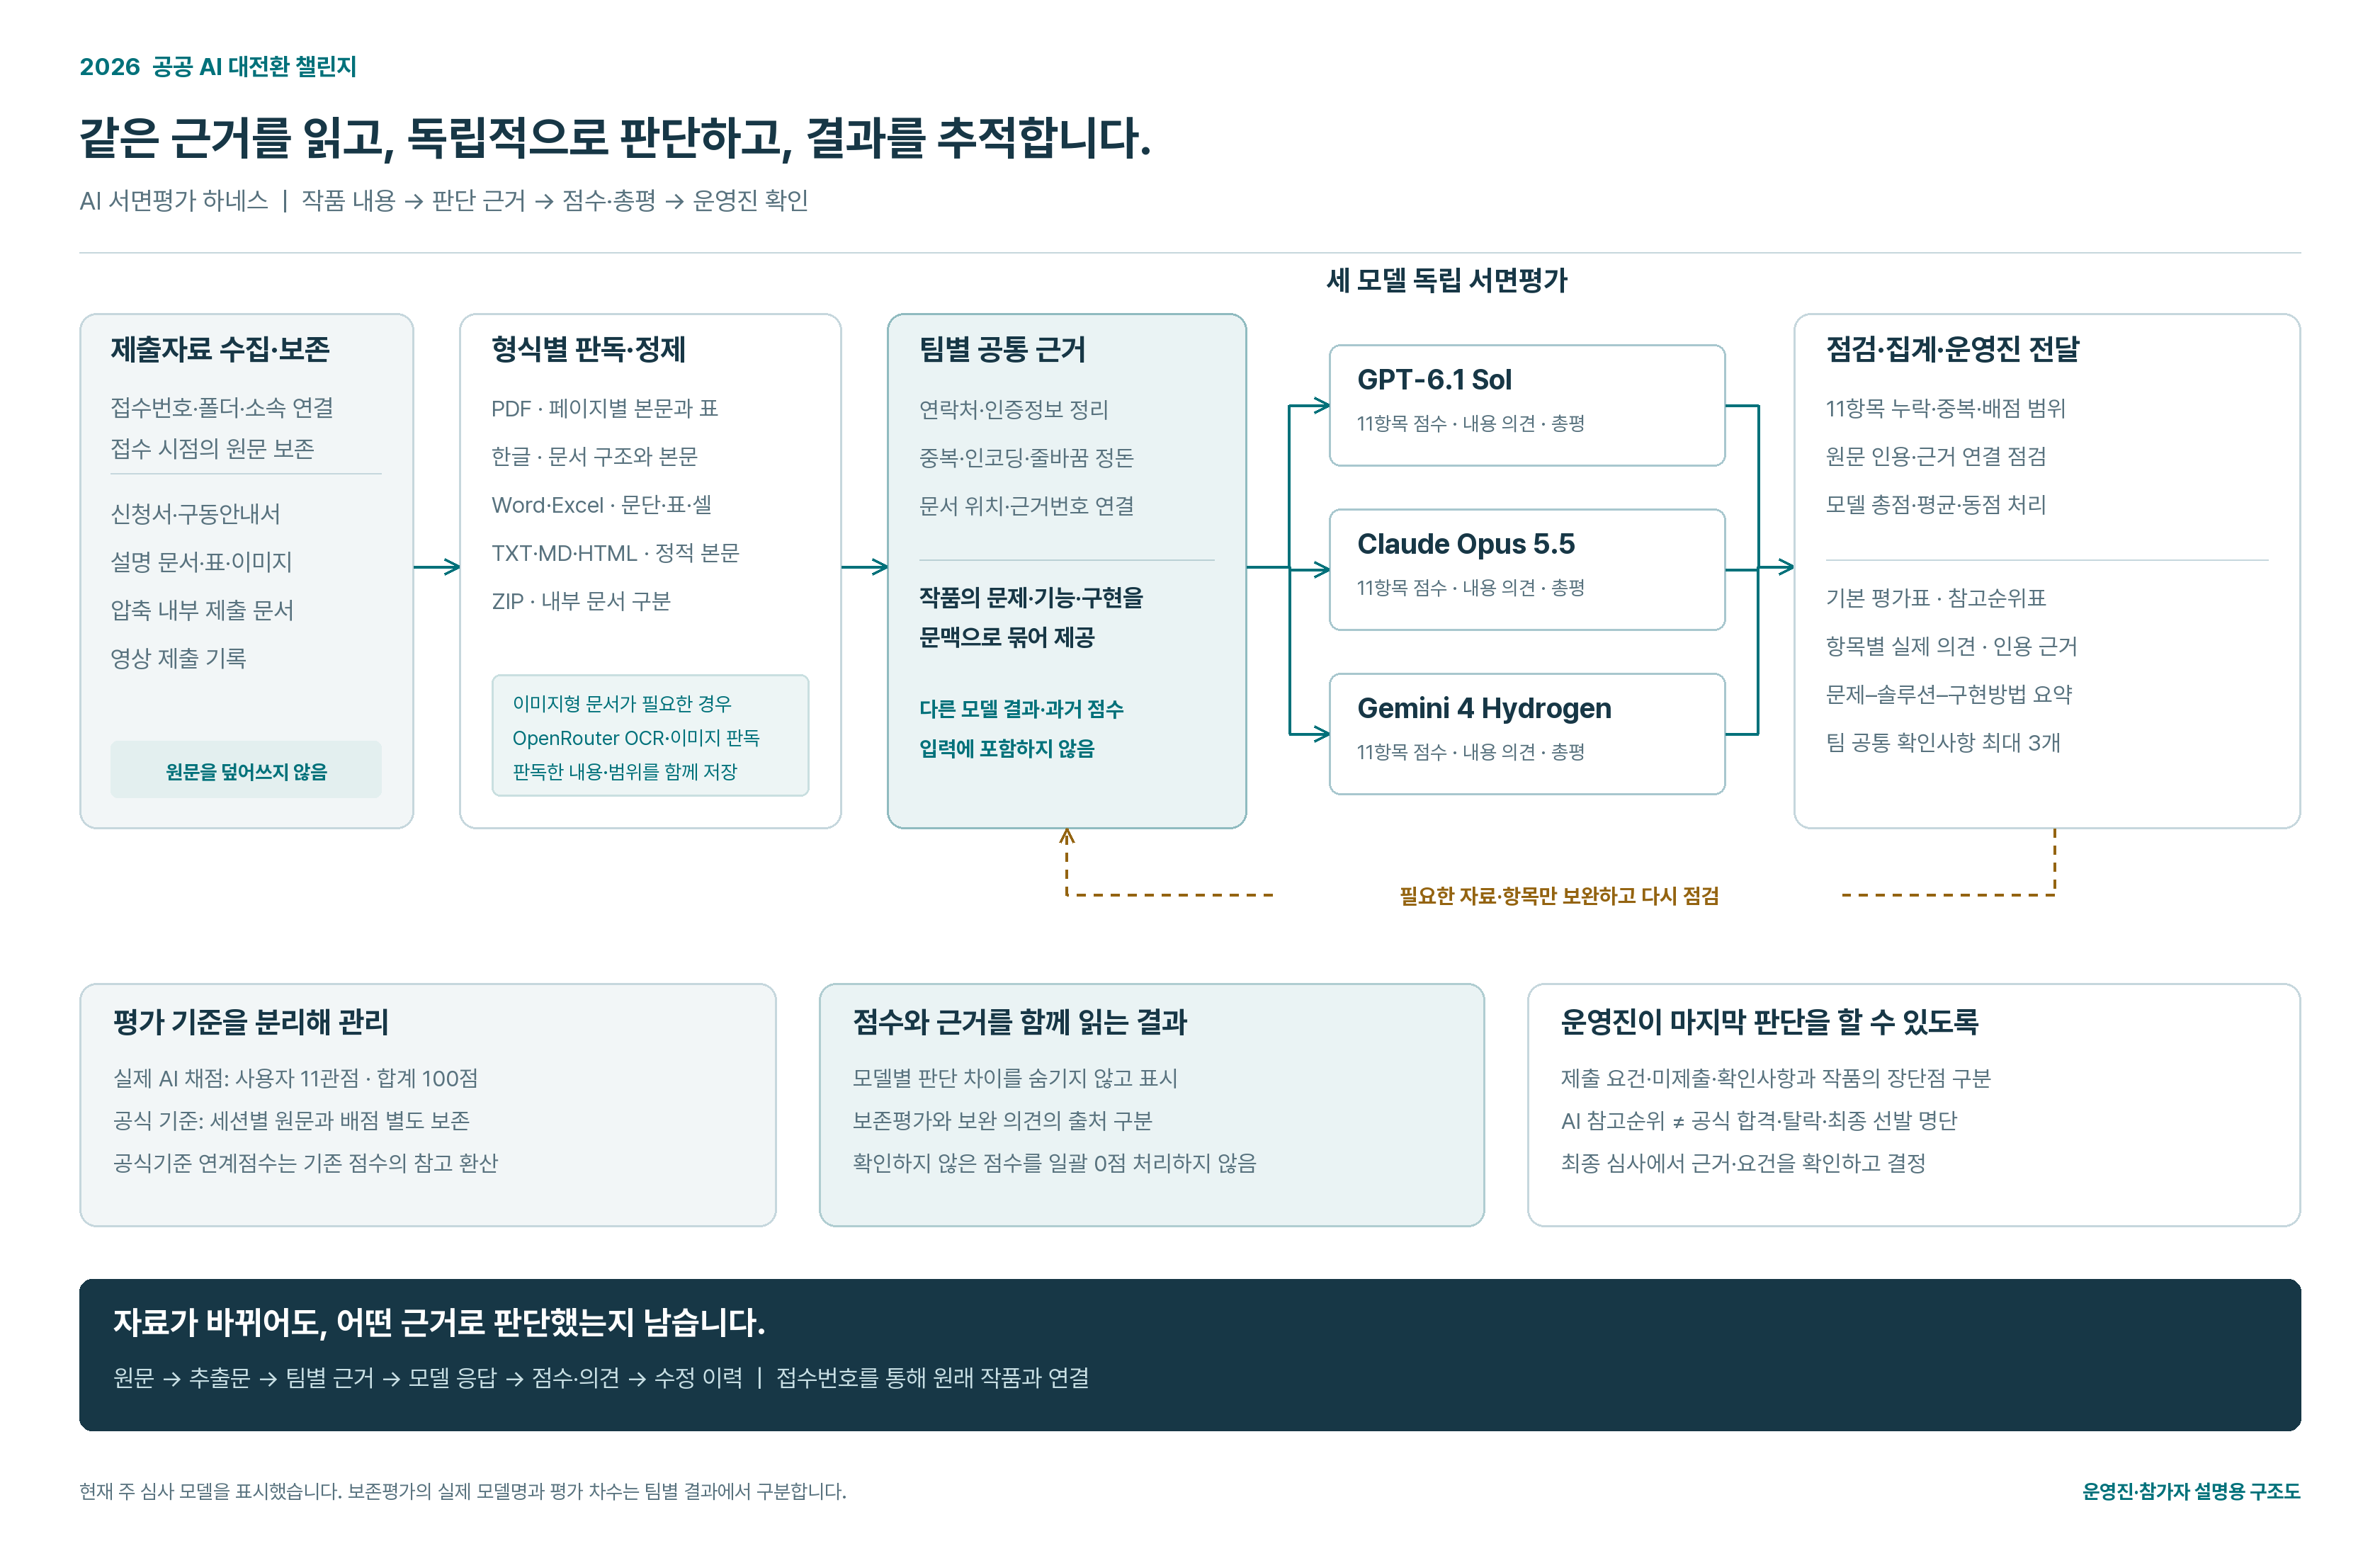
접수번호와 팀별 제출자료를 연결합니다. 원본과 목록을 보존해 평가 화면에서 원래 접수 건으로 돌아갈 수 있게 합니다.
PDF·한글·Word·Excel·텍스트·압축 내부 자료를 파일 유형에 맞게 처리합니다. 필요한 이미지형 문서는 허용된 OpenRouter 판독 경로를 사용하고, 추출한 본문·표를 근거 단위로 저장합니다.
연락처·이메일·인증정보를 정리한 자료를 평가에 사용합니다. 공개 결과에는 기관·접수번호·작품 설명을 남겨 식별과 확인이 가능하게 합니다.
각 모델이 팀별 근거와 평가기준을 읽고 11항목 점수·의견·총평을 작성합니다. 다른 모델의 점수나 총평을 전달해 결론을 따라가게 하는 방식으로 평가하지 않습니다.
저장된 응답의 형식, 항목과 점수 범위, 합계 및 근거 연결을 확인합니다. 기존 응답은 보존하며 보완·수정 차수는 따로 기록합니다. 채택한 점수의 평균과 공동순위 규칙으로 참고순위를 계산합니다.
팀별 요약·제출자료·점수·의견을 함께 제공합니다. 판단 차이나 제출요건 확인 요청이 있으면 저장된 근거와 평가 응답을 다시 대조할 수 있습니다.
다시 확인할 수 있는 기록
전처리 결과, 평가기준, 요청 내용, 모델, 응답을 실행 ID와 해시로 연결합니다. 해시는 자료가 바뀌었는지 구분하는 식별값이며, 내용의 진실성이나 판단의 정확성을 보증하는 값은 아닙니다. 판독 결과와 응답은 파일로 남겨 후속 질문 때 다시 활용합니다.
독립 평가와 기준 연계를 구분
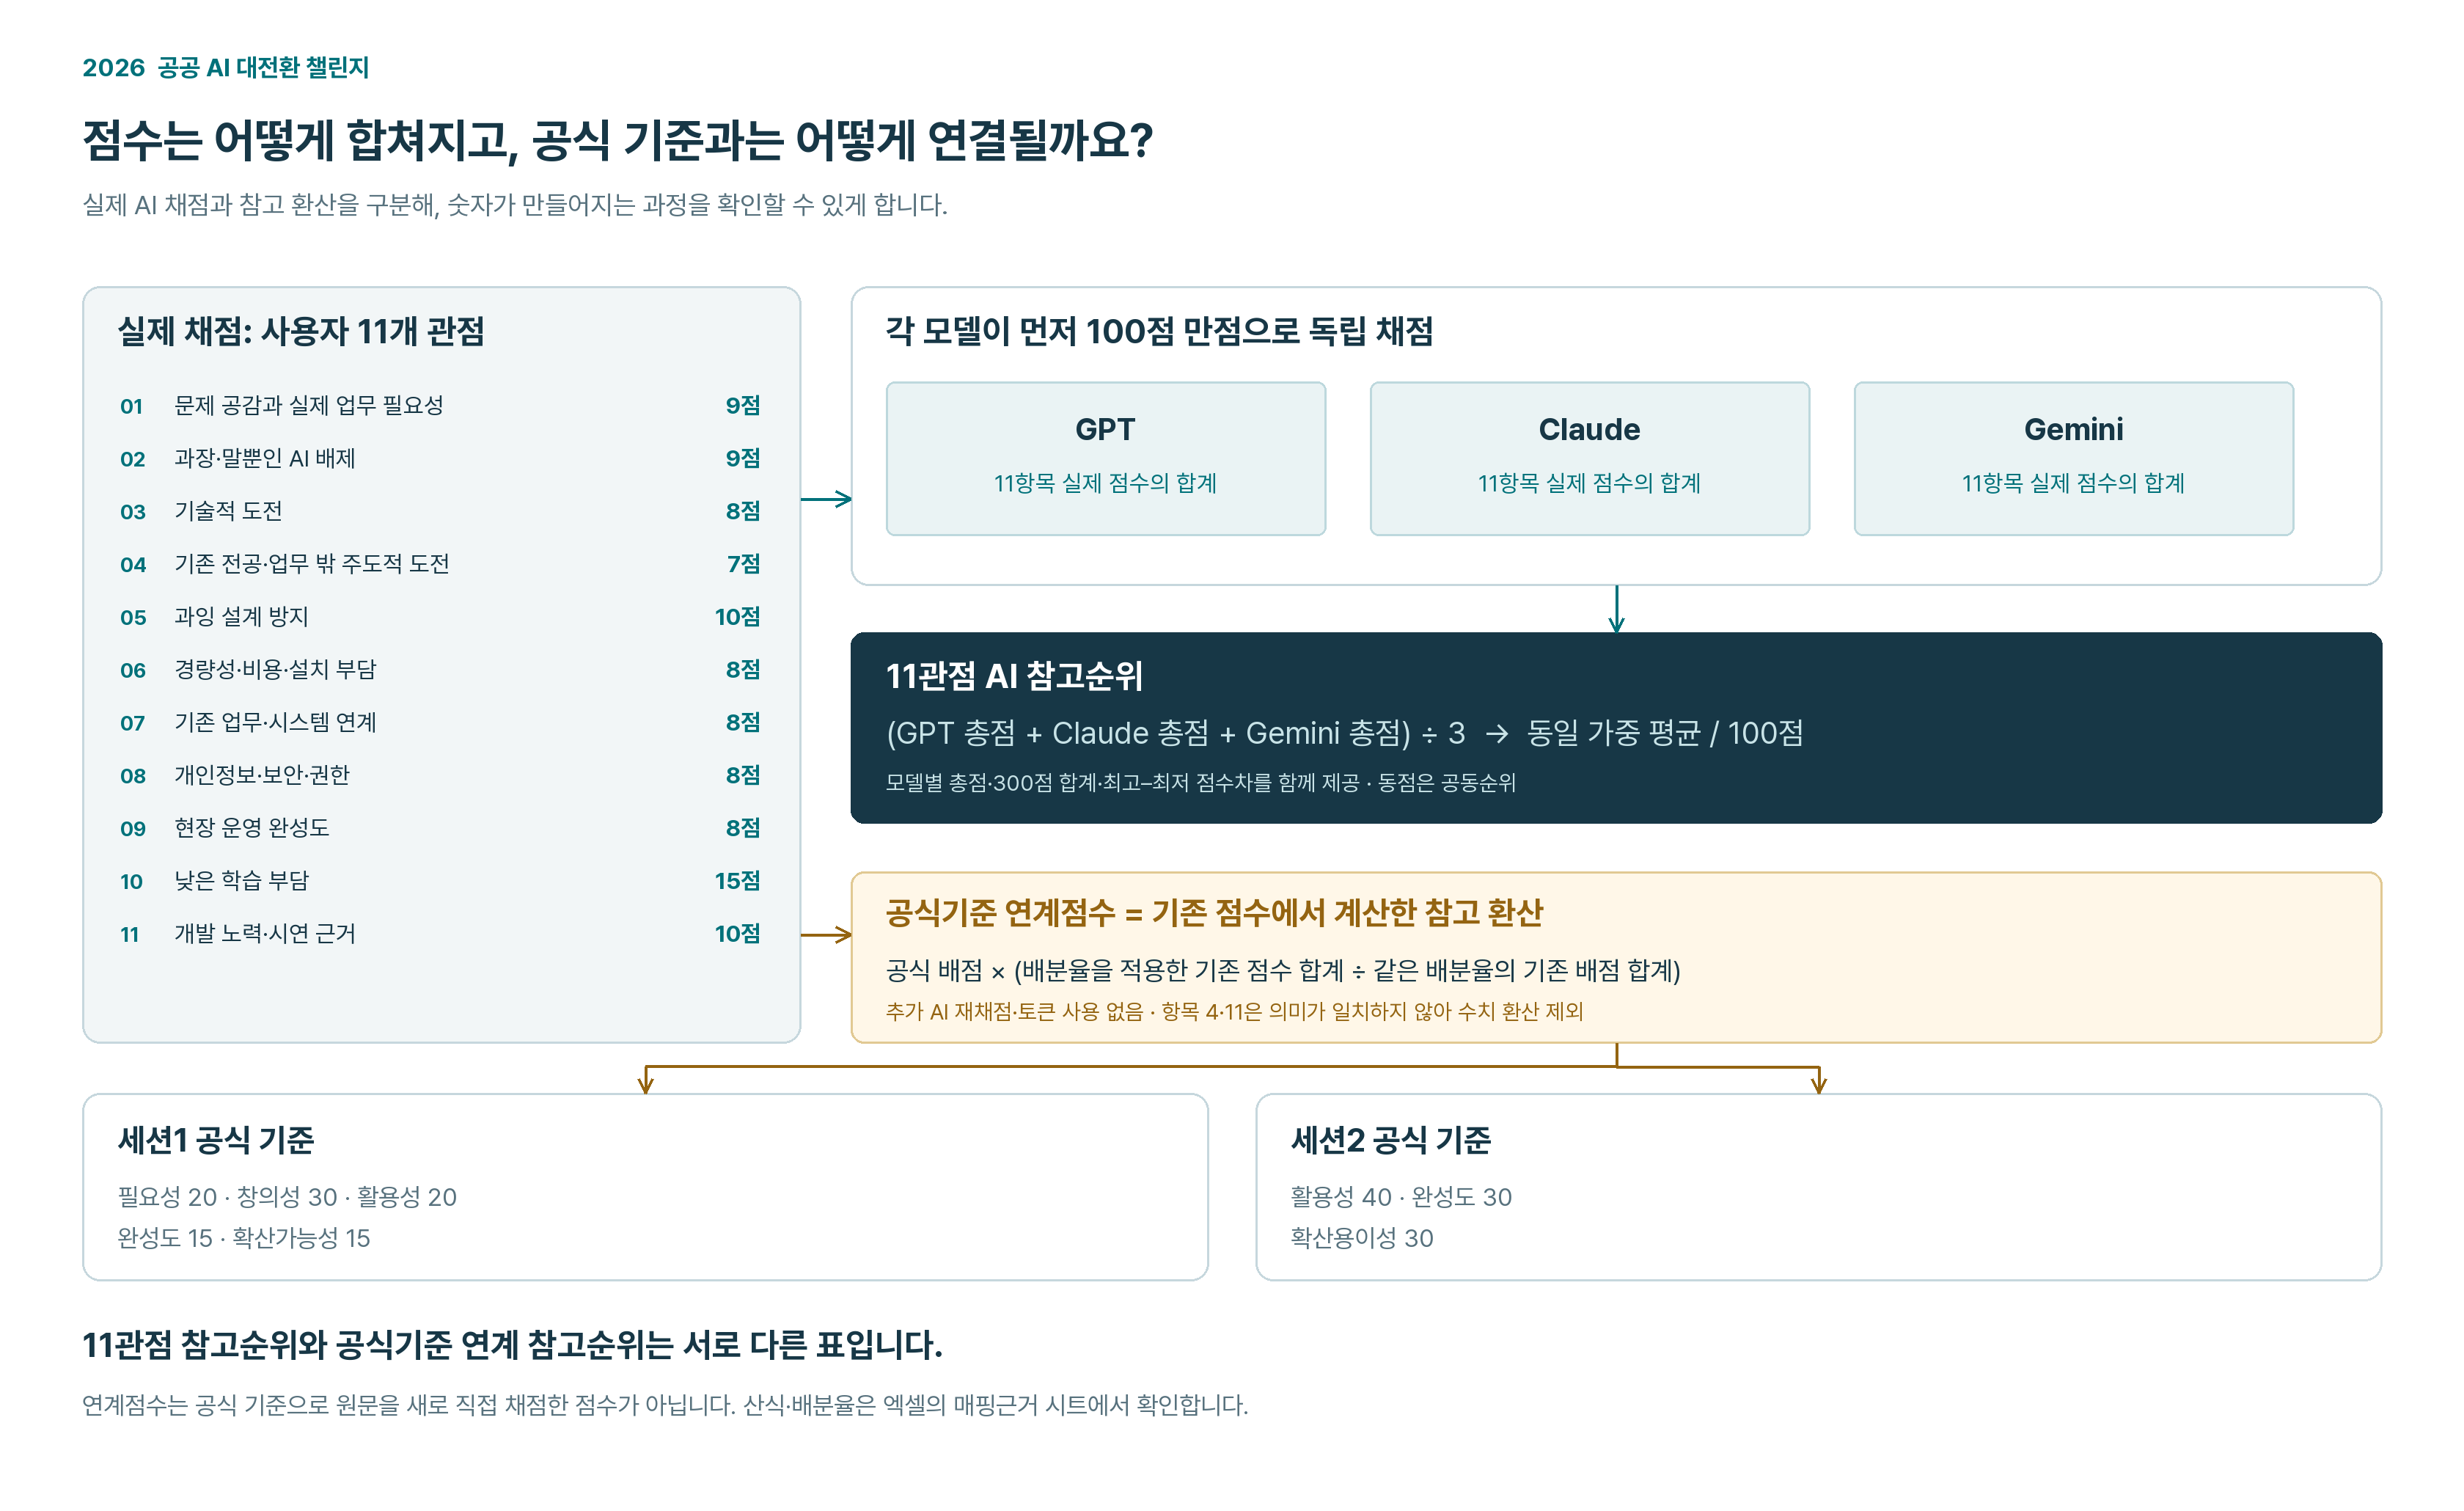
실제 AI 채점은 11개 해석형 기준으로 수행했습니다. 세션별 공식기준 점수는 연결 가능한 기존 항목을 환산한 참고값으로 별도 표시합니다. 공식기준으로 원문을 새로 재채점한 결과를 뜻하지 않습니다. 세션2 순위는 지정과제별로 구분합니다.
비용과 작업 범위의 추적
OpenRouter 요청·응답 기록의 모델별 토큰과 API 보고 비용을 집계합니다. 문서 판독·채점·의견 보완·요약의 사용량을 구분하며, 사용자 확인 청구 총액 USD 803.753과 모델별 로그 비용 사이의 차액은 임의 배분하지 않습니다.
평가와 최종 선정의 경계
서면에 나타난 구현 내용·업무 효과·운영 가능성을 평가한 참고 결과입니다. 영상 기록 미확인, 모델 간 점수차, 추가 확인 요청을 곧바로 결격으로 바꾸지 않습니다. 제출 사실과 선정 요건은 운영진이 근거를 대조해 확정합니다.
초기 평가 보존본, 수정 제출물 재심사, 누락 의견 보완은 각 차수의 기록을 유지합니다. 현재 세 모델 계열은 GPT-6.1 Sol·Claude Opus 5.5·Gemini이며, Gemini는 변경 전 모델과 초기 보존평가가 포함돼 작품별 실제 모델명을 확인해야 합니다. 자동 형식 검증이 모든 내용 오류를 찾아냈다는 의미는 아닙니다.