서면평가와 공식 기준
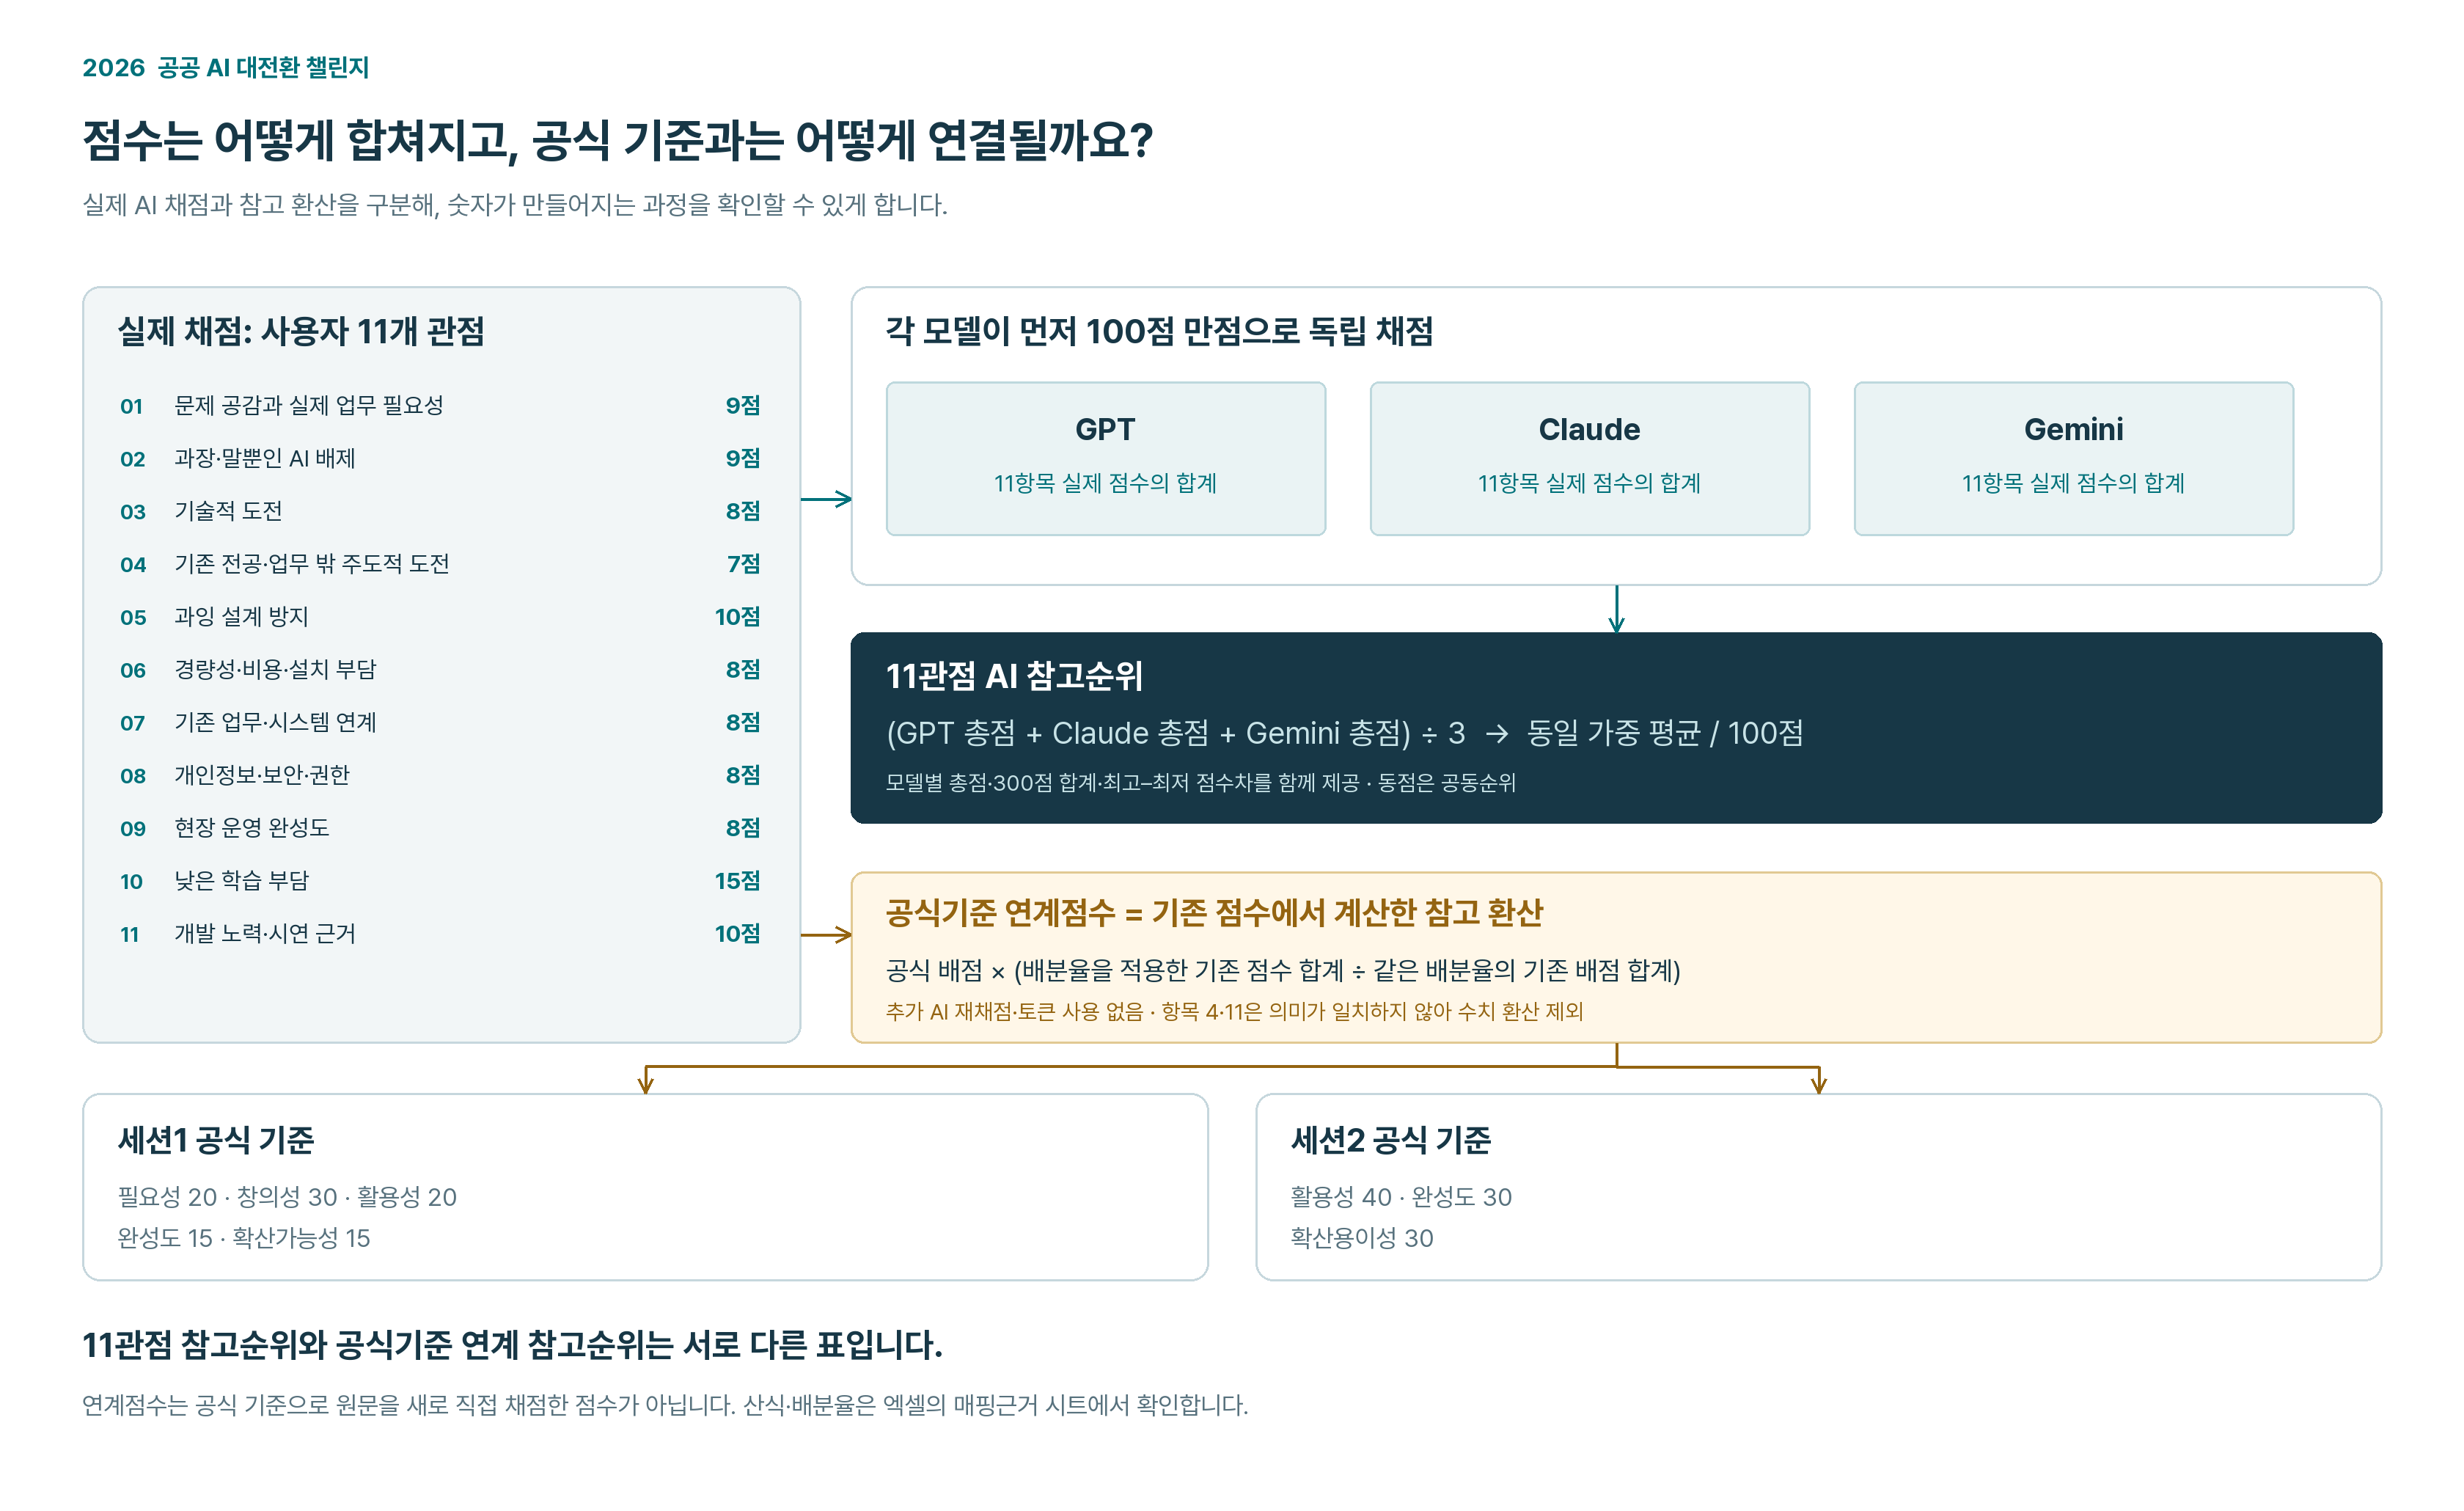
실제 모델 점수는 11항목 합계 100점입니다. 세 모델 총점의 평균으로 AI 참고순위를 계산하며 동점은 공동순위입니다.
공식기준 연계점수는 기존 점수를 의미가 연결되는 공식 항목에 환산한 참고값입니다. 공식 기준으로 원문을 새로 직접 채점한 결과와 구분합니다.
세션1: 필요성 20 · 창의성 30 · 활용성 20 · 완성도 15 · 확산가능성 15
세션2: 활용성 40 · 완성도 30 · 확산용이성 30
2026 PUBLIC AI CHALLENGE
어떤 문제를 풀었는지, 어떤 근거로 평가했는지 한 작품씩 확인하세요.
| 참고순위 | 접수·기관 | 프로젝트 | GPT | Claude | Gemini | 평균 / 100 | 11항목 원점수GPT · Claude · Gemini 순 / 항목명에 배점 안내 | 상세 |
|---|
검색 결과가 없습니다. 다른 검색어나 접수번호를 입력해 주세요.
세션2 참고 대시보드의 기관·지역·과제·활용 모델 분포를 함께 살펴봅니다. 이 통계 자체가 작품 점수나 결격 판정은 아닙니다.
참고 원본에 정리된 항목입니다. 현재 평가와 대조해 제출 요건을 확인하세요.
| 번호 | 기관 | 과제 | 지역 | 활용 모델 | 공통 기반 | 모델 교체 |
|---|
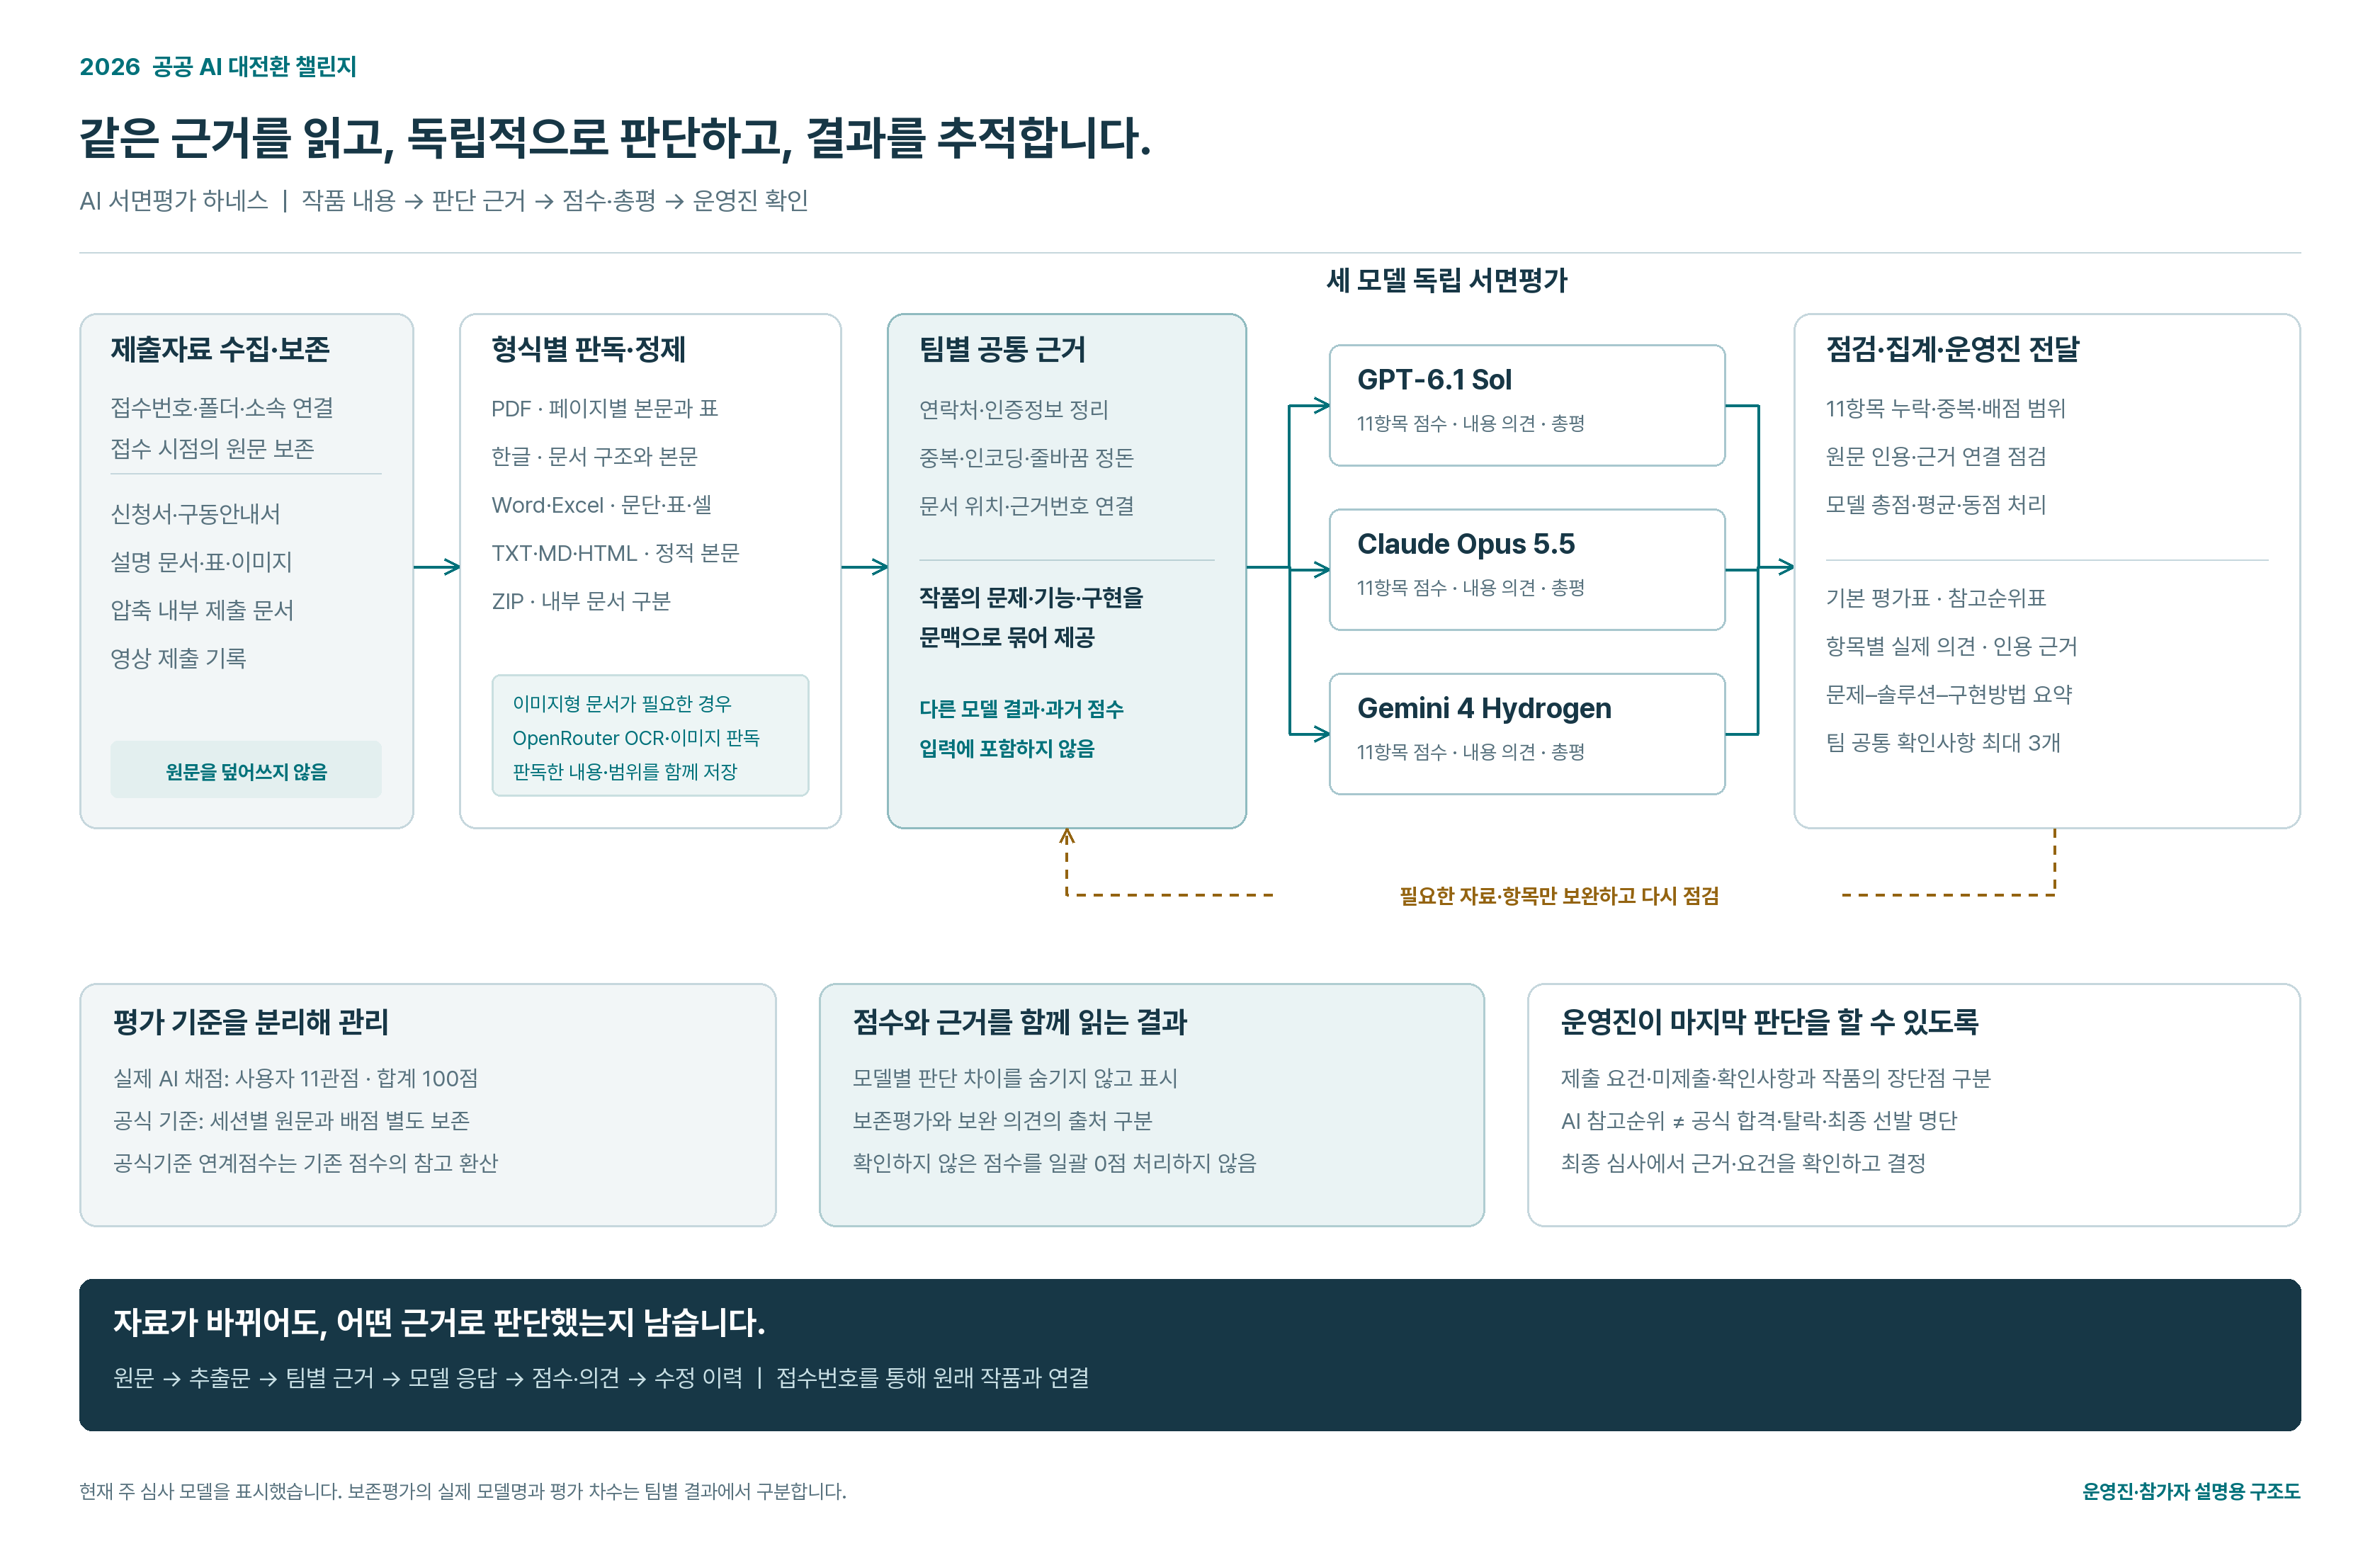
팀별 제출 문서를 읽고 문제의 필요성·구현 근거·현장 적용 가능성을 11개 관점에서 평가했습니다. 다른 모델의 점수와 과거 평가를 새 모델 입력에 보내지 않았습니다.
실제 모델 점수는 11항목 합계 100점입니다. 세 모델 총점의 평균으로 AI 참고순위를 계산하며 동점은 공동순위입니다.
공식기준 연계점수는 기존 점수를 의미가 연결되는 공식 항목에 환산한 참고값입니다. 공식 기준으로 원문을 새로 직접 채점한 결과와 구분합니다.
세션1: 필요성 20 · 창의성 30 · 활용성 20 · 완성도 15 · 확산가능성 15
세션2: 활용성 40 · 완성도 30 · 확산용이성 30
PDF·한글·Word·Excel·설명문·압축 내부 문서를 형식별로 읽고, 필요한 이미지형 문서는 허용된 OpenRouter 판독 경로를 사용했습니다.
연락처·이메일·인증정보를 정리한 근거를 사용합니다. 공개 결과에는 접수번호·기관·작품 설명을 남겨 팀을 확인할 수 있게 했습니다.
미제출·요건 확인과 작품의 장단점을 구분합니다. 최종 선발과 공식 결격 판단은 운영진 검토를 거칩니다.
최종 결과에 채택되지 않은 보완 차수와 문서 판독·요약도 역할별로 포함합니다. 입력·출력 토큰에 캐시·추론 부분집합을 다시 더하지 않습니다.
| 세션 | 모델 | 역할 | 수신 | 입력 토큰 | 출력 토큰 | API 보고 비용 |
|---|
전체 묶음에는 두 세션의 평가표·순위표·상세 의견·활동보고서가 들어 있습니다. 작품별 내용은 이 사이트에서도 바로 조회할 수 있습니다.
748번은 실제 작품 미제출로 확인돼 기본 작품 목록에서 별도 처리했습니다. 408·509·732번은 수정본 재심사 결과를 반영했습니다.